
统计分析
支持的统计与机器学习方法,以及如何解读结果。
高质量的临床科研不仅需要严谨的数据提取,更依赖规范的统计学建模。CherryN 内置了针对临床真实世界研究 (RWE) 优化的本地统计计算引擎,无需手动编写复杂的 R 或 Python 代码,即可一站式完成从基线描述到复杂生存分析的完整计算。
#支持的分析方法
#1. 基线特征描述表 (Table 1)
- 连续型变量:自动检验数据分布的正态性与偏度,正态数据输出均值 ± 标准差 (Mean ± SD),偏态数据输出中位数与四分位距 (Median [IQR]);组间假设检验两组采用 Welch t 检验,多组采用单因素方差分析 (ANOVA),偏态数据自动采用 Kruskal-Wallis / Mann-Whitney U 秩和检验;
- 分类型变量:输出频数与百分比 (N, %),组间比较采用 Pearson 卡方检验(2×2 表格自动带 Yates 连续校正,期望频数 < 5 时改用 Fisher 精确检验);
- 标准化均差 (SMD):连续变量采用 Cohen's d,分类变量采用 Yang-Dalton 算法,自动计算组间 SMD 值,直观评估基线协变量平衡程度(通常以 SMD < 0.1 作为平衡标准)。
#2. 回归建模分析
- 多因素 Logistic 回归:适用于二分类临床结局(例如:是否发生院内死亡、是否发生术后急性肾损伤),输出未调整与多因素调整后的比值比 (Odds Ratio, OR) 及其 95% 置信区间;
- Cox 比例风险回归:适用于时间-事件生存数据(例如:ICU 入住 28 天/90 天全因死亡风险),自动计算风险比 (Hazard Ratio, HR) 及其 95% 置信区间;
- 多模型渐进调整:系统支持输出非调整模型 (Model 1)、微调模型 (Model 2,调整人口学与基础合并症) 与全调整模型 (Model 3,额外调整实验室指标与急重症评分),验证结论的稳定性。
#3. 混杂偏倚控制与因果推断
- 倾向性评分匹配 (PSM):基于 Logistic 回归估计个体倾向得分,支持 1:1 或 1:k 贪婪最邻近匹配与卡钳值设定,并输出匹配前后的协变量平衡分布图;
- 倾向评分加权 (IPTW / ATO):支持逆概率处理加权 (IPTW) 与重叠加权 (Overlap Weighting, ATO),利用倾向评分构建加权伪人群,实现更高效的混杂偏倚校正。
#4. 探索性与进阶分析
- 限制性立方样条 (RCS):用于探究连续型临床指标(如血压、血钙、乳酸、BMI 等)与死亡风险之间的非线性剂量-反应关系,自动输出非线性检验 P 值并绘制 RCS 曲线图;
- 竞争风险模型 (Fine-Gray):在重症 ICU 结局中,患者出院与死亡常常构成竞争事件;系统支持拟合亚分布风险模型 (Subdistribution Hazard),避免传统 Kaplan-Meier 法对死亡率的高估;
- 亚组分析与交互作用:按年龄段、性别、是否合并休克等进行分层亚组分析,绘制亚组森林图,并计算交互作用 P 值 (P for interaction);
- 临床预测模型与机器学习:支持 Lasso、Random Forest、XGBoost、LightGBM 等算法,并提供 DeLong 检验 (ROC 比较)、校准曲线 (Calibration)、决策曲线分析 (DCA) 与 SHAP 可解释性分析。
#查看结果
统计计算完成后,结果会以直观的图形和格式化表格呈现在工作台中:
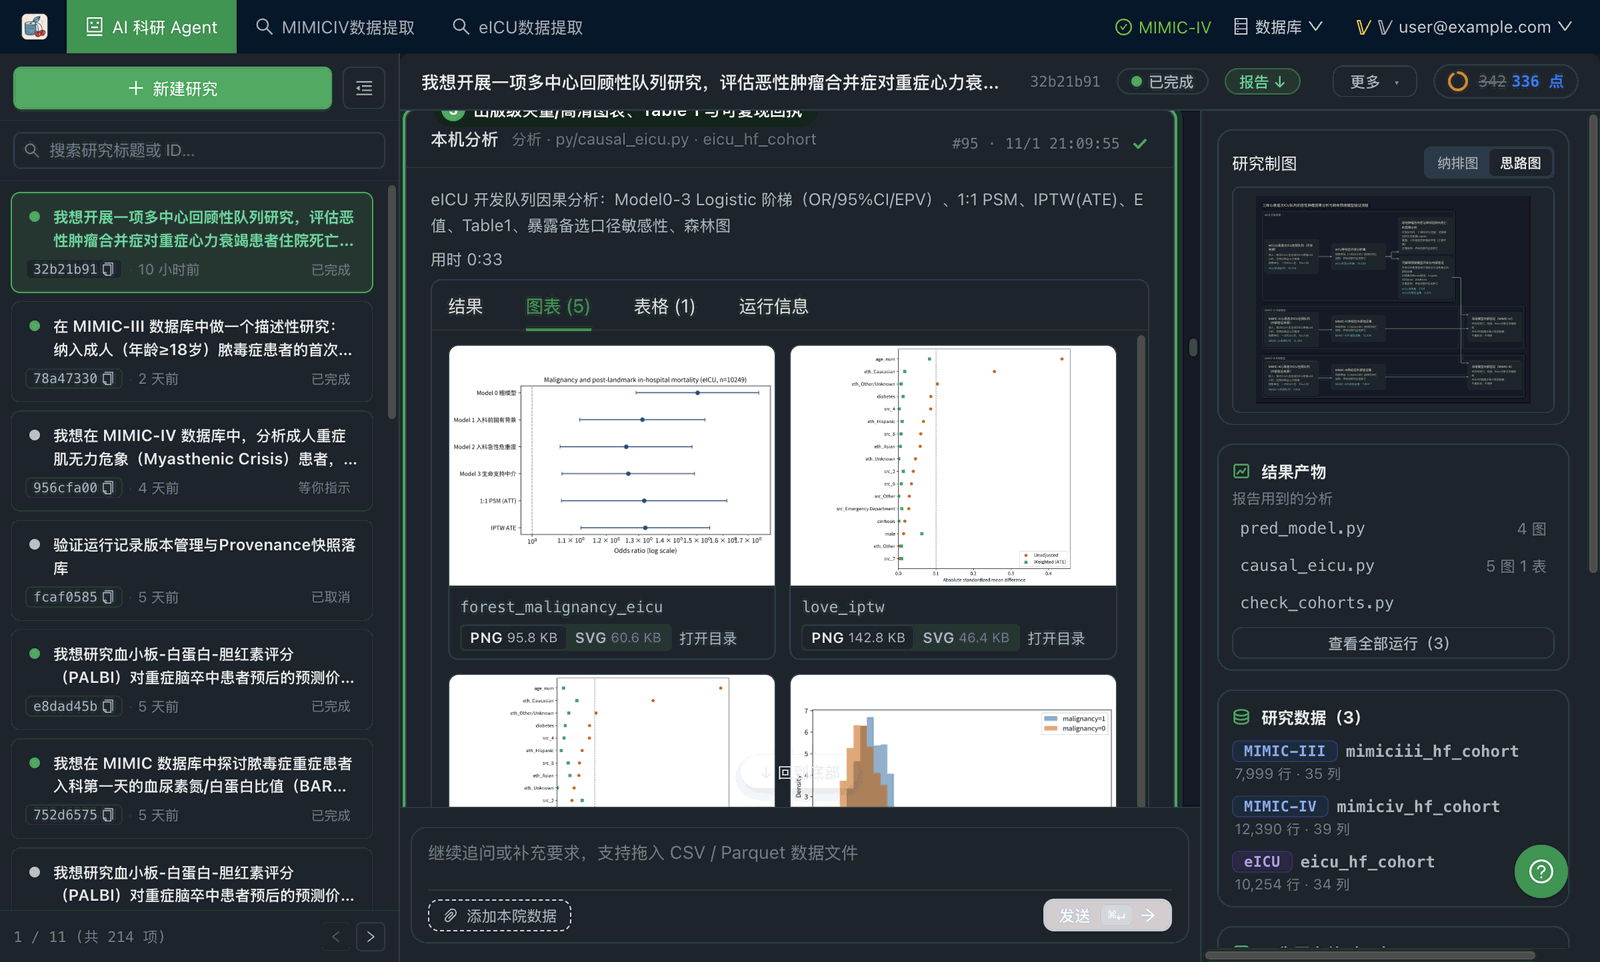
#核心指标解读速查
| 指标 | 含义 | 临床判读准则 |
|---|---|---|
| HR / OR | 效应量倍数 | • > 1:暴露因子与结局发生呈正相关(危险因素) • < 1:暴露因子与结局发生呈负相关(保护因素) • = 1:无相关性 |
| 95% CI | 95% 置信区间 | • 区间不包含 1(例如 1.25 ~ 1.80):效应量在统计学上显著不等于 1 • 区间跨越 1(例如 0.85 ~ 1.35):提示尚不能认为存在统计学关联 |
| P 值 | 假设检验显著性 | • 通常以 P < 0.05 作为存在统计学显著性差异的判定阈值 |
#诊断与敏感性分析
为确保分析结论在学术评审中的稳健性,系统还提供以下诊断手段:
- 比例风险 (PH) 假定检验:对 Cox 回归进行基于 Schoenfeld 残差的假设检验;若某协变量严重违背 PH 假定,系统会提示采用时变协变量或分层 Cox 模型处理;
- 多重共线性诊断 (VIF):自动计算协变量的方差膨胀因子 (Variance Inflation Factor),若 VIF > 5 会提示共线性风险;
- E-value 检验:计算评估结论对未测量混杂偏倚耐受力的 E 值,量化潜在混杂需达到何种强度才能推翻当前发现。