
完成你的第一项研究
用一个完整例子走一遍:提出问题、确认方案、取数、分析、导出。
CherryN 采用“自然语言交互 + 临床决策锁定 + 本地安全执行”的科研范式。本篇教程以一项真实的临床回顾性研究为例,带你完整体验从提出科学假说到获得统计图表的全流程。
#先用 MIMIC-IV Demo 免费跑一遍
第一次使用,建议先部署 MIMIC-IV Demo 示例库,不用开通会员,也不用下载约 140 GB 的完整库。
- 进入【新建研究】页,在数据源提示里点击【免费部署 MIMIC-IV Demo】;也可以点击顶部导航的【数据库】,选择【下载/安装与管理】,在面板里部署 Demo;
- 部署完成后,状态条会显示“MIMIC-IV Demo 已就绪”和实测患者人数。Demo 约含 100 名患者,只需要约 1 GB 磁盘空间;
- 新建研究页会出现几条示例问题(基线特征表、分组比较、数据质量探索、生存曲线)。点击任意一条,问题会填入输入框,修改后再发送即可;
- 新用户赠送的 100 点算力,足够跑完一个简单的描述性研究。
后面的章节以完整库为例,Demo 的操作流程完全一样。
#提出研究问题
启动 CherryN 后,进入 AI 科研 Agent 工作台。你只需在对话框中以自然语言描述你的研究设想与临床假说。
例如,输入:
“我想在 MIMIC-IV 数据库中开展一项回顾性队列研究,评估恶性肿瘤合并症对重症心力衰竭患者住院死亡风险的影响,并构建具备可解释性的临床决策预测模型。”
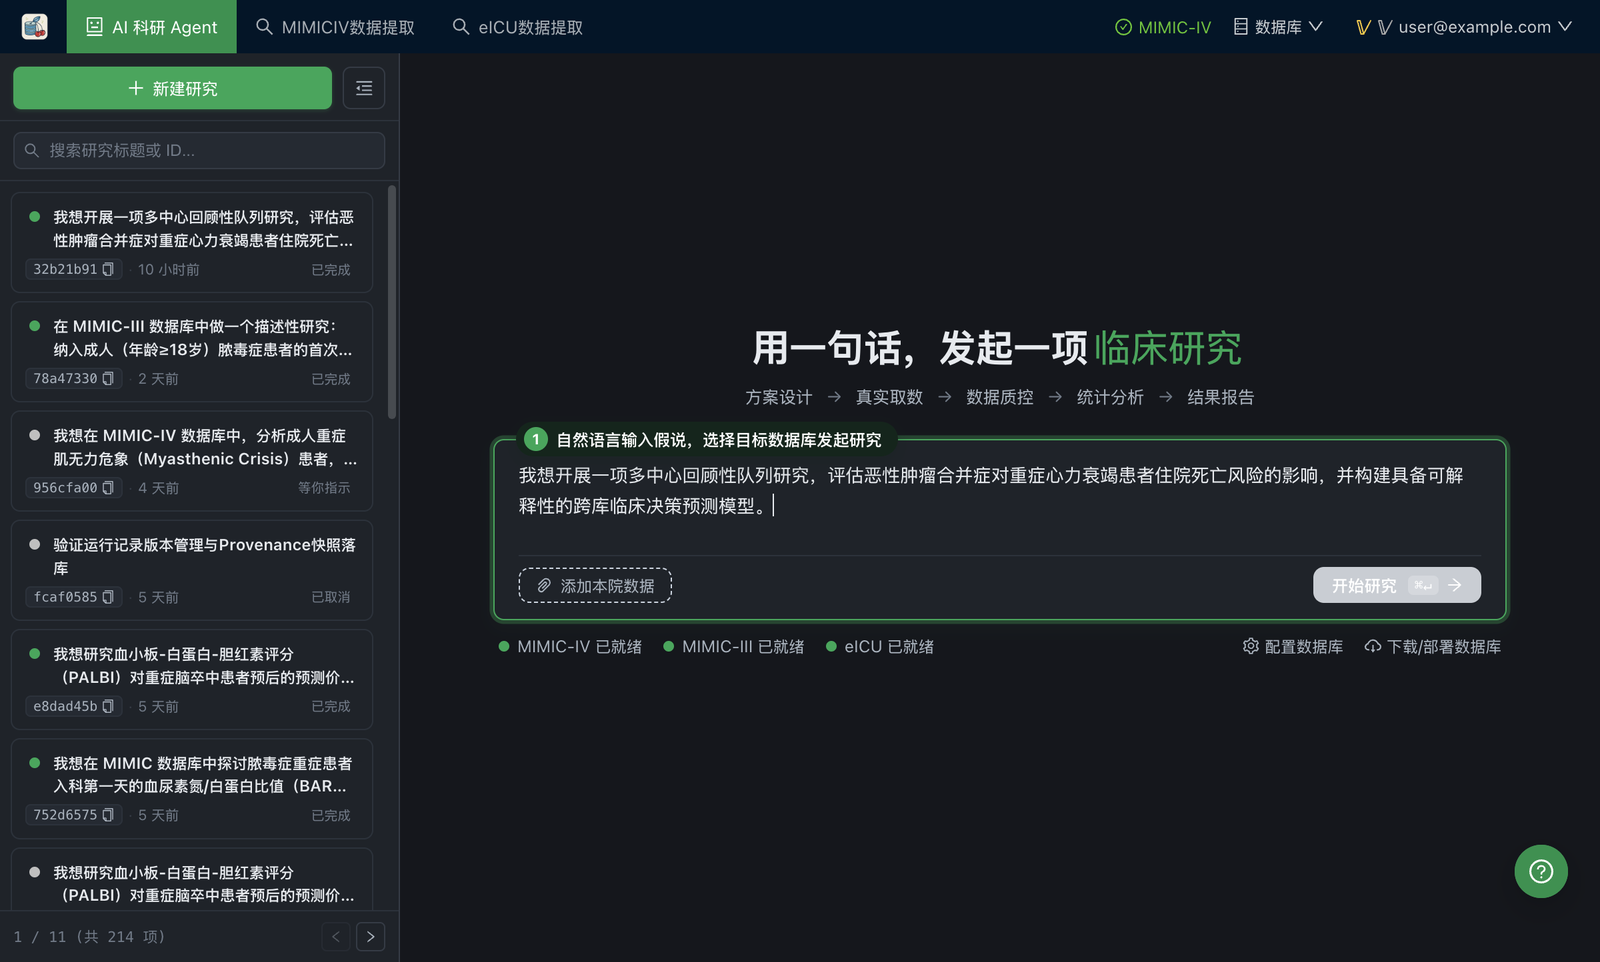
在输入框下方,你可以选择本次研究所依据的数据源(如 MIMIC-IV、eICU 或本地上传的科研数据表)。确认无误后点击发送。
#确认研究方案
接收到研究假说后,Agent 会调用内置的 15 张重症科研决策卡,对临床概念进行标准化映射,并生成一份规范的结构化研究方案。随后,界面上会呈现一张分析锁定确认卡。
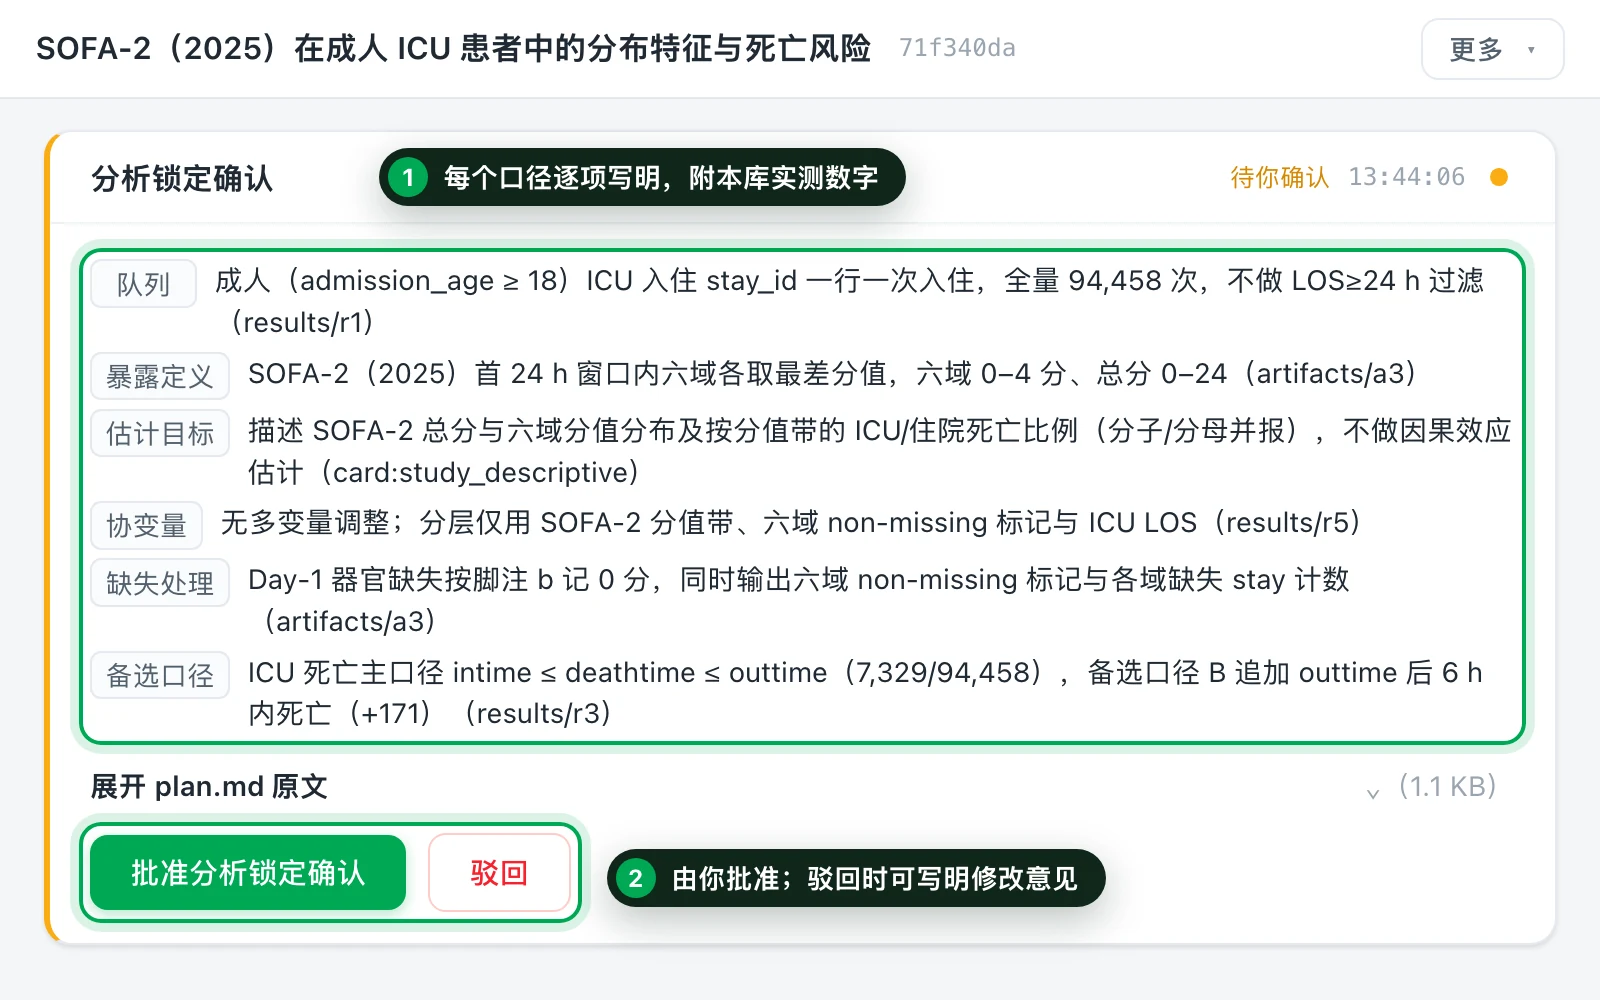
确认卡将研究中的关键口径显式列出:
- 目标队列:明确年龄限制(如
admission_age ≥ 18)、ICU 入住记录(stay_id)的去重规则及是否限制住院时长; - 暴露因子与干预定义:明确时间窗口(如入科首个 24 小时)、指标取最差值还是平均值、药物剂量计算口径;
- 临床结局终点:明确主要结局(如住院死亡率、ICU 死亡率、28 天全因死亡率);
- 协变量清单:列出基线人口学特征、合并症评分(如 Charlson 合并症指数)与生命体征。
为什么需要确认卡?
临床研究中“一个概念多种读法”是导致结论偏差的主要原因。确认卡将所有分析口径在动手前彻底透明化,杜绝了隐藏的代码歧义。你可以直接点击【批准分析锁定】,也可以点击【驳回】或在对话框中提出调整要求(例如“请增加对糖尿病亚组的分析”)。
#取数与质控
确认研究方案后,系统会自动在本地启动取数与数据质控流程,所有操作均在本机完成:
- 本地 SQL 取数:根据锁定方案,自动在本地 PostgreSQL 数据库中编写并物化中间数据表,提取队列与特征变量;
- 自动化数据质控 (QC):本地 Python 执行引擎对提取的数据集进行完整性审计,包括:
- 检查行数与受试者 ID 的唯一性;
- 统计连续变量的极值分布并执行医学合理范围截断;
- 统计各字段的缺失率画像,为后续模型选择提供依据。
质控通过后,系统才会将合规的数据集传递给后续的统计分析模块。
#查看分析结果
数据清洗完成后,本地统计计算引擎会自动根据方案要求拟合对应的统计与机器学习模型,并在界面中呈现图表与解读:
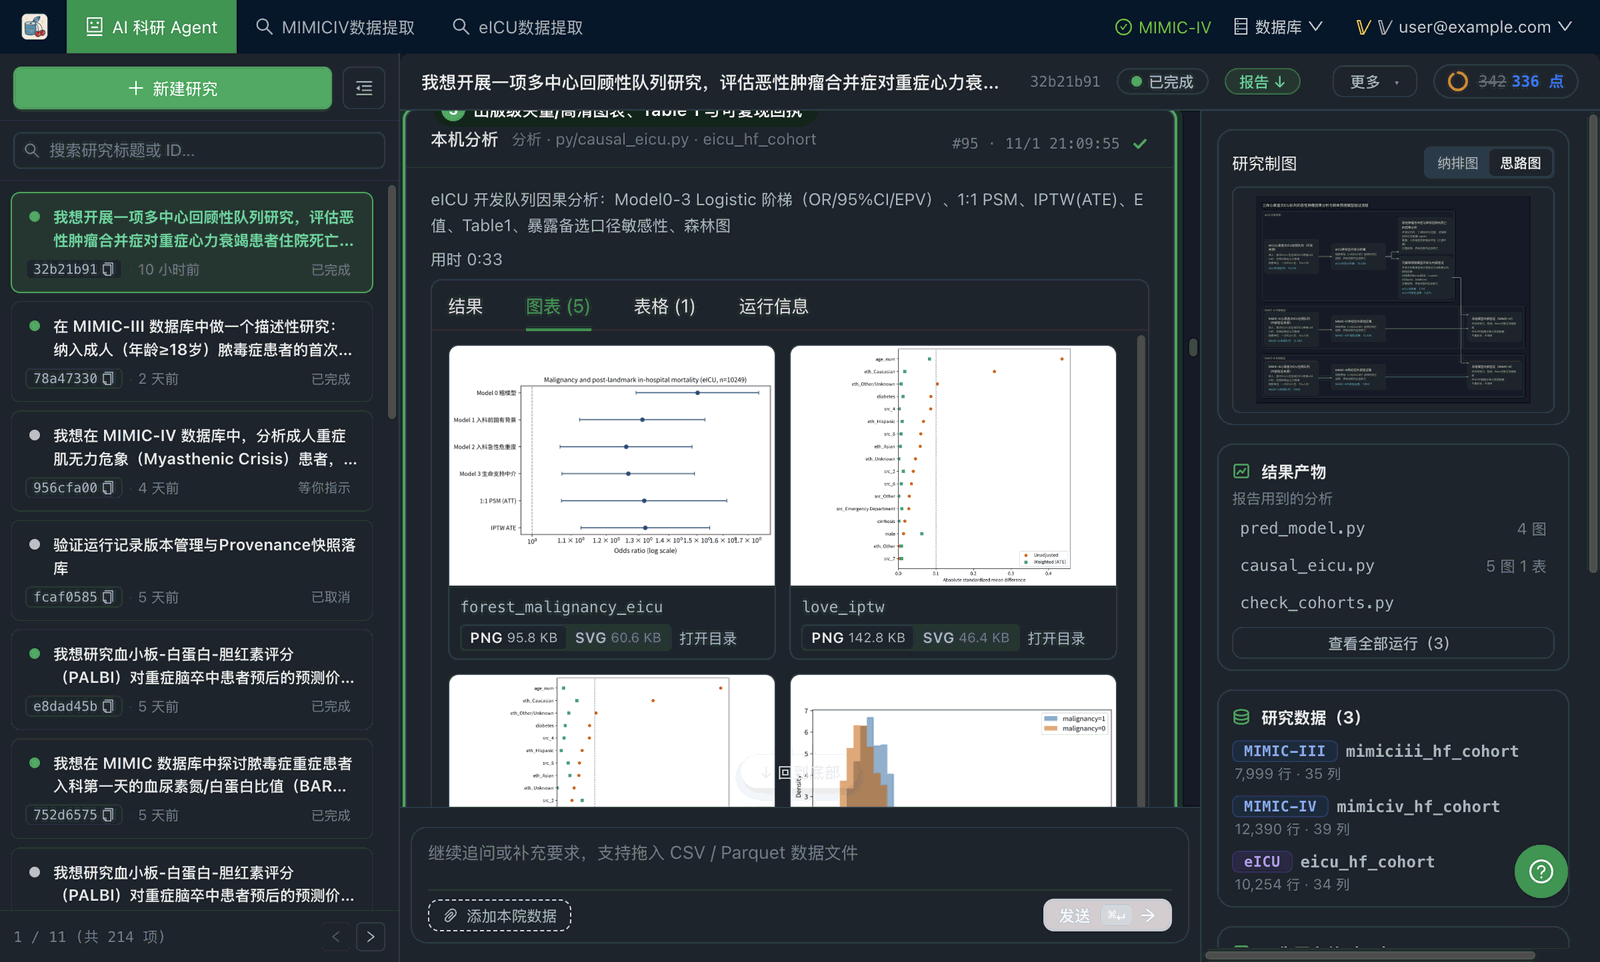
- 基线特征表 (Table 1):呈现暴露组与对照组的人口学与临床基线分布差异,自动标注假设检验 P 值;
- 模型回归结果:展示多因素 Logistic 回归或 Cox 比例风险模型的调整效应量(OR / HR)及其 95% 置信区间;
- 可视化图形:提供 Kaplan-Meier 生存曲线、限制性立方样条 (RCS) 曲线以及亚组分析森林图等高质量制图展示。
#导出与复现
完成研究后,你可以在工作台操作菜单中点击【导出研究资料】进行成果打包与导出:
- 发表级高清图表:导出 300 DPI 高清 PNG 及无损 SVG 矢量图,可直接用于医学论文插图;
- 结构化结果表格:导出符合学术规范的 Table 1 (
table1.csv)、回归模型系数表(CSV 格式)及结构化指标(result.json); - 全链可复现包:系统为本次研究生成了不可篡改的执行回执链(Receipt Chain),包含完整的研究方案、建表 SQL、清洗逻辑与 Python 建模代码。其他研究者在相同数据源上运行该回执包,可 100% 精确复现出完全一致的统计结果与图表。